Am 19. Oktober 2026 hat Jensen Huang beim Invest in Germany Summit in Berlin die deutschen Fertigungsdaten als eine Art nationalen Rohstoff beschrieben. Bundeskanzler Merz hat den Mittelstand aufgefordert, diese Daten für KI zu öffnen.
Die Diagnose stimmt. Die Schlussfolgerung, die viele daraus ziehen, nicht.
Rohstoff heißt: Er muss gefördert, aufbereitet und verarbeitet werden, bevor er etwas wert ist. Ein Werk mit zehn Jahren Historian-Daten besitzt Erz, kein Produkt.
In unseren Projekten im Maschinen- und Anlagenbau scheitern industrielle KI-Vorhaben fast nie am Modell. Sie scheitern an allem, was zwischen Maschine und Modell liegt.
Daten besitzen ist nicht dasselbe wie Daten verstehen
Ein industrieller Data-Moat entsteht nicht durch Volumen. Er entsteht durch das Wissen, was die Daten in einer konkreten Situation bedeuten.
Eine Fertigungslinie erzeugt Zeitreihen, Kamerabilder, Alarme, Wartungsberichte und Qualitätsdaten. Ob 78 Grad an einem Lager Normalbetrieb oder ein Frühwarnsignal sind, steht in keinem dieser Datensätze allein. Es hängt ab von:
- Maschinentyp und Baujahr
- Charge, Rezeptur und Auftrag
- Belastung, Werkzeugzustand und Umgebung
- Wartungshistorie und zuletzt getauschte Komponenten
Dieses Kontextwissen ist verteilt: auf MES, ERP, Historian, Wartungssoftware. Und auf die Köpfe der Schichtführer, die es nie aufgeschrieben haben. Wenn diese Menschen gehen, verschwindet es still, ohne Alarm und ohne Fehlermeldung. Das ist der Knowledge-Drain in der Produktion, und er entwertet jedes Datenarchiv, dem der Kontext fehlt.
Dazu kommen die üblichen Brüche. Zeitstempel aus verschiedenen Systemen, die nicht synchron laufen. Kameras, die neu ausgerichtet wurden. Sensoren, die nach einem Tausch anders kalibriert sind. Ein Modell, das nur den historischen Messwert sieht, interpretiert diese Veränderungen als Muster.
Daraus folgt eine unbequeme Rechnung:
Ein Betreiber mit deutlich weniger Daten, aber sauber dokumentierten Ausfallursachen, ist bei Predictive Maintenance weiter als einer mit einem riesigen, unannotierten Archiv.
Mehr Daten ersetzen kein Wissen über die Daten. Der Vorsprung entsteht dort, wo technische Signale mit Prozesssemantik, Fehlerursachen und einer verlässlichen Rückmeldung verbunden werden.
Edge oder Cloud ist die falsche erste Frage
Die richtige lautet: Welche Entscheidung muss auch ohne Netzwerkverbindung funktionieren?
Nehmen wir eine optische Qualitätsprüfung. Eine Kamera nimmt im Takt der Linie Bilder auf, ein Modell erkennt Defekte, ein Aktuator schleust das Bauteil aus. Für diese Kette zählen drei Dinge: deterministische Latenz, ein sicherer Aktuatorpfad und ein nachvollziehbarer Umgang mit Unsicherheit.
Wer jedes Bild an einen entfernten Endpunkt schickt, macht Netzqualität und Cloud-Verfügbarkeit zum Bestandteil der Qualitätskontrolle. Für eine nachgelagerte Analyse ist das vertretbar. Für eine zeitgebundene Maschinenaktion ist es eine Abhängigkeit, die niemand bewusst gewählt hat.
Lokale Inferenz hat einen zweiten Effekt: Rohdaten werden vor Ort gefiltert. Übertragen werden nur Fehlerfälle, Metadaten und repräsentative Stichproben. Das spart unter passenden Bedingungen Bandbreite und Speicher.
Die Cloud wird dadurch nicht überflüssig. Sie bleibt oft der bessere Ort für Training, werksübergreifende Vergleiche, Modellversionierung und Langzeitanalysen.
Die Architekturfrage ist also keine Glaubensfrage. Sie folgt aus der Entscheidung, die das System treffen muss, und aus dem Preis, den ein Ausfall dieser Entscheidung kostet.
Sechs Schichten zwischen Maschine und Modell
Das Modell ist nur eine von sechs Schichten
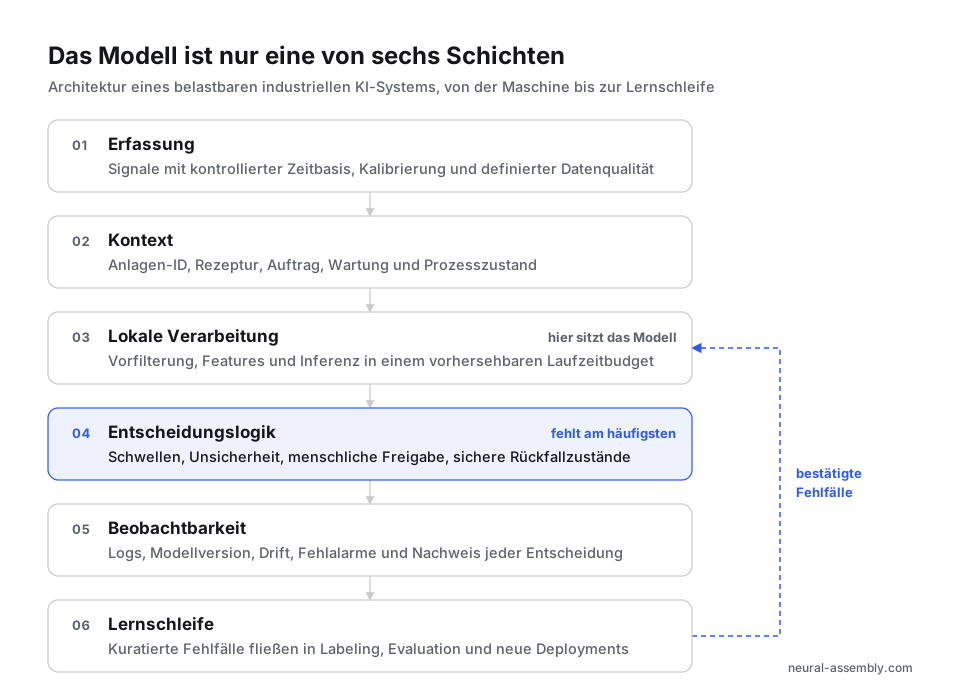
In Architekturdiagrammen industrieller KI steht meist ein Kasten mit der Aufschrift „Modell“. Ein belastbares System braucht mindestens sechs Ebenen, und das Modell ist nur ein Teil einer davon.
Zwei dieser Ebenen fehlen in fast jedem Konzept, das wir zur Prüfung bekommen.
Ebene 4, die Entscheidungslogik. Ein Modell sollte nicht stillschweigend die Autorität erhalten, eine Anlage anzuhalten, nur weil seine Konfidenz über einem Wert liegt. Die Entscheidung gehört in eine definierte Betriebslogik mit Schwellen, Freigaben und sicheren Rückfallzuständen.
Sicherheit darf nicht vom Verhalten eines statistischen Modells abhängen.
Ebene 6, die Lernschleife. Ohne verlässliche Rückmeldung, welche Meldung tatsächlich ein Fehler war, entsteht kein Data-Flywheel. Es entsteht ein System, das dieselben Fehlannahmen mit wachsender Selbstsicherheit reproduziert.
Das ist die These, gegen die sich viele Projektteams wehren: Ein Modell ohne Lernschleife wird in Produktion nicht besser. Es veraltet nur langsamer, als man es bemerkt.
Ein erfolgreicher PoC beweist weniger, als die Folie behauptet
Im Proof of Concept gibt es ein ausgewähltes Gerät, einen kooperativen Prozess und ein kuratiertes Dataset. In Produktion gibt es drei Schichten, Firmware-Updates, wechselndes Licht, neue Produktvarianten und einen Wartungsplan, den das KI-Team nicht kontrolliert.
Die Accuracy-Folie beantwortet deshalb die leichteste Frage. Die schweren kommen danach:
- Was passiert, wenn ein Sensor beschädigt ist und plausible, aber falsche Werte liefert?
- Wer gibt ein neues Modell frei, und wie wird zurückgerollt?
- Darf ein Standort offline gehen, ohne Entscheidungen zu verlieren?
- Kann ein Ingenieur in drei Monaten nachvollziehen, warum ein Teil ausgeschleust wurde?
- Was kostet ein Fehlalarm an der realen Linie, in Stillstandsminuten und Ausschuss?
Wer diese Fragen erst nach dem PoC stellt, hat die Produktentwicklung nicht abgeschlossen. Er hat ihren schwierigsten Teil verschoben.
Die meisten industriellen KI-Projekte im Mittelstand sterben nicht im PoC. Sie sterben im Übergang danach, weil niemand für den Betrieb budgetiert hat.
Was der Mittelstand konkret tun sollte
Nicht mit einer unternehmensweiten KI-Plattform beginnen. Mit einer einzigen Entscheidung beginnen, deren Kosten und Rahmenbedingungen bekannt sind.
- Eine Entscheidung wählen. Soll ein Teil ausgeschleust werden? Muss ein Instandhalter alarmiert werden? Lohnt eine Zusatzinspektion? Je klarer die Kosten einer falschen Entscheidung, desto besser der Startpunkt.
- Eine Linie instrumentieren. Erfassung mit kontrollierter Zeitbasis, Kontextdaten aus MES und Wartung angebunden, reale Fehlfälle mit Ursache dokumentiert.
- Baselines festlegen. Wie gut ist der heutige Prozess ohne KI? Ohne diese Zahl ist jede Accuracy-Angabe wertlos.
- End-to-End testen. Nicht nur Modellgüte, sondern Verfügbarkeit, Recovery, Zeit bis zur Entscheidung und Kosten einer falschen Aktion.
- Erst dann skalieren. Mit standardisierter Erfassung, gemeinsamen Metadaten, wiederholbaren Deployments und klarer Ownership zwischen IT, OT und Produktion.
Das klingt weniger aufregend als ein eigenes Foundation-Model. Es ist näher an dem, womit in der Industrie Geld verdient und Risiko reduziert wird.
Und es hat einen Nebeneffekt, der beim Thema Datensouveränität oft übersehen wird: Wer Erfassung, Kontext und Entscheidungslogik selbst beherrscht, kann Modelle und Anbieter austauschen. Wer nur Rohdaten an eine Plattform liefert, kann das nicht.
Der Vorsprung ist eine Leistung, kein Besitz
Deutschlands Industriedaten sind real. Die Engineering-Kompetenz auch. Aber beides ist kein Burggraben, den man einmal besitzt und dann verteidigt.
Wer Daten unverbunden lässt, Entscheidungen zentralisiert, die lokal fallen müssen, und nach dem PoC aufhört, verschenkt diesen Vorteil. Und zwar an Wettbewerber mit weniger Daten und besserer Architektur.
Das industrielle KI-Rennen gewinnt nicht das größte Modell. Es gewinnen die Systeme, die auch am Dienstagmorgen auf einer schlecht angebundenen Linie zuverlässig entscheiden.
Die Frage ist nicht, wie viele Daten unsere Maschinen erzeugen. Die Frage ist, was unsere Architektur daraus machen kann.